안녕하세요,
그로메트릭 입니다. 🐸
지난 4월, 그로메트릭이 자체 기획·개발 중인 SaaS형 보안 정보 및 이벤트 관리 솔루션 'GroSaaS SIEM'이 중소벤처기업부 주관 디딤돌 R&D 지원 사업에 최종 선정되었다는 기쁜 소식을 전해드린 바 있습니다.
저희는 앞으로 18개월 동안 GroSaaS를 단순한 로그 수집 도구가 아닌, ML 기반 지능형 위협 탐지, SOAR 연계 자동화 대응, m OpenSearch 기반의 전방위 가시성을 모두 갖춘 '클라우드 네이티브 지능형 보안 플랫폼'으로 고도화하는 대장정에 돌입합니다.
이 거대한 과제를 수행하며 저희는 완성된 결과물만 보여드리기보다는, 그 이면의 치열한 고민과 기술적 난관을 돌파해 나가는 생생한 과정을 투명하게 나누고자 합니다.
클라우드 보안의 새로운 표준을 만들어가는 기록, 'GroSaaS 개발 일지'의 대망의 첫 번째 에피소드를 지금 시작합니다!
눈에는 같은 글자인데 검색이 안 된다고? 로그 한글 인코딩(NFC) 통일기 🛠️
GroSaaS는 여러 장비에서 쌓이는 로그를 한곳에 모아 분석하는 서비스입니다. 이번 개발일지에서는 로그를 모으는 과정에서 만난 한글 인코딩 문제와, 이를 NFC 방식으로 통일한 과정을 가볍게 정리했습니다.
문제: 눈에는 같은데, 컴퓨터는 다른 글자
이번에 다룬 로그는 WAF(웹 방화벽)에서 나온 로그입니다. WAF는 웹 공격을 막고 기록을 남기는 장비입니다. 이 로그에는 한글이 섞여 있습니다.
한글 글자 가는 컴퓨터 안에서 두 가지 모양으로 저장될 수 있습니다.
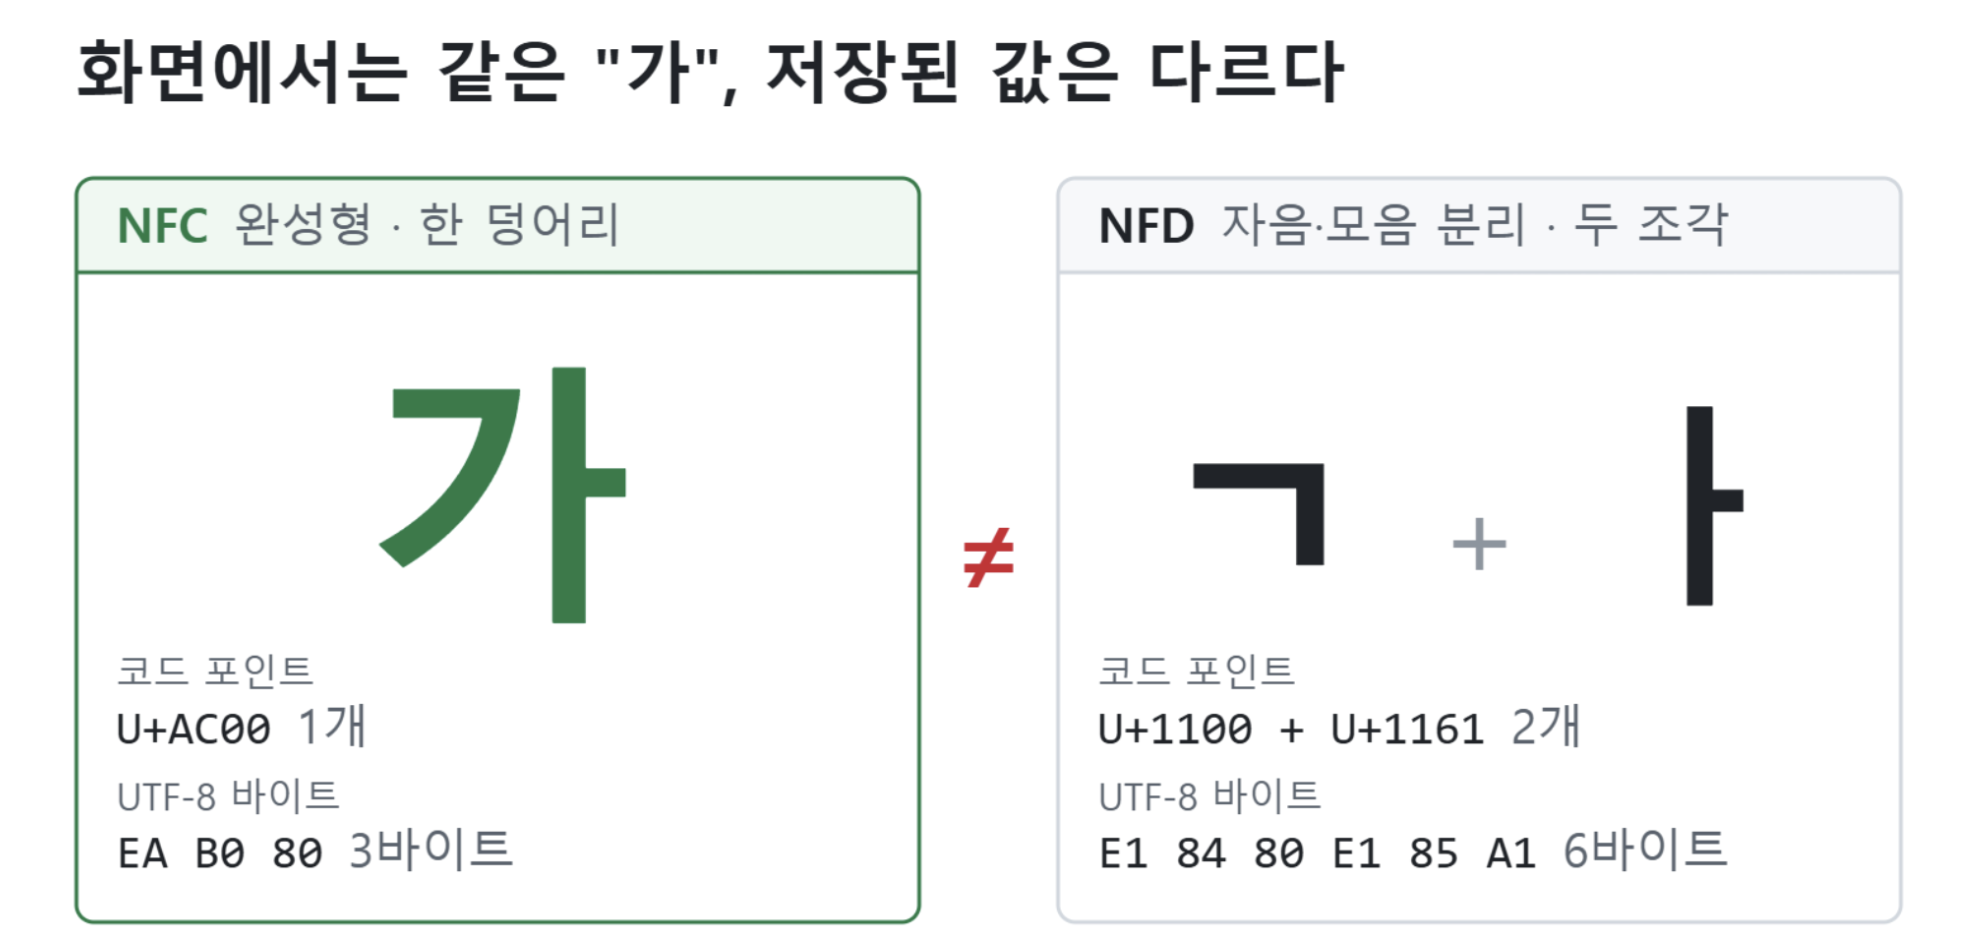
| 방식 | 저장 모양 | 쉽게 말하면 |
| NFC | 가 (한 덩어리) | 글자가 완성된 상태 |
| NFD | ㄱ + ㅏ (두 조각) | 글자가 자음·모음으로 풀어진 상태 |
화면에서는 똑같이 가로 보여도 컴퓨터는 서로 다른 글자로 처리합니다. 그래서 이런 일이 생깁니다.
- 완성형으로 저장된 차단을 검색하면 조각난 차단(ㅊㅏㄷㅏㄴ)이 나오지 않음
- 같은 이벤트인데 개수를 셀 때 서로 다른 항목으로 갈라짐
로그에 섞여 있는 한글을 전부 NFC 한 가지 방식으로 통일해서 내보내는 것을 이번 목표로 삼았습니다.
Fluentd: 로그를 모으고 가공해서 보내는 도구 🪄
Fluentd는 오픈소스 로그 수집기입니다. 여러 곳에서 들어오는 로그를 받아 원하는 형태로 가공한 뒤 저장소로 보냅니다. 2011년 Treasure Data에서 처음 만들었고, 지금은 CNCF(Cloud Native Computing Foundation)의 졸업 프로젝트이며 Apache 2.0 라이선스로 배포됩니다. 코어는 Ruby로 작성되어 있고, 성능이 중요한 일부는 C 확장으로 처리합니다.
GroSaaS 파이프라인에서 Fluentd의 위치
GroSaaS에서 로그는 다음 순서로 흐릅니다.
보안 장비 → Fluent Bit(수집 에이전트) → Kafka → Fluentd(파싱·정제) → OpenSearch(저장·검색)
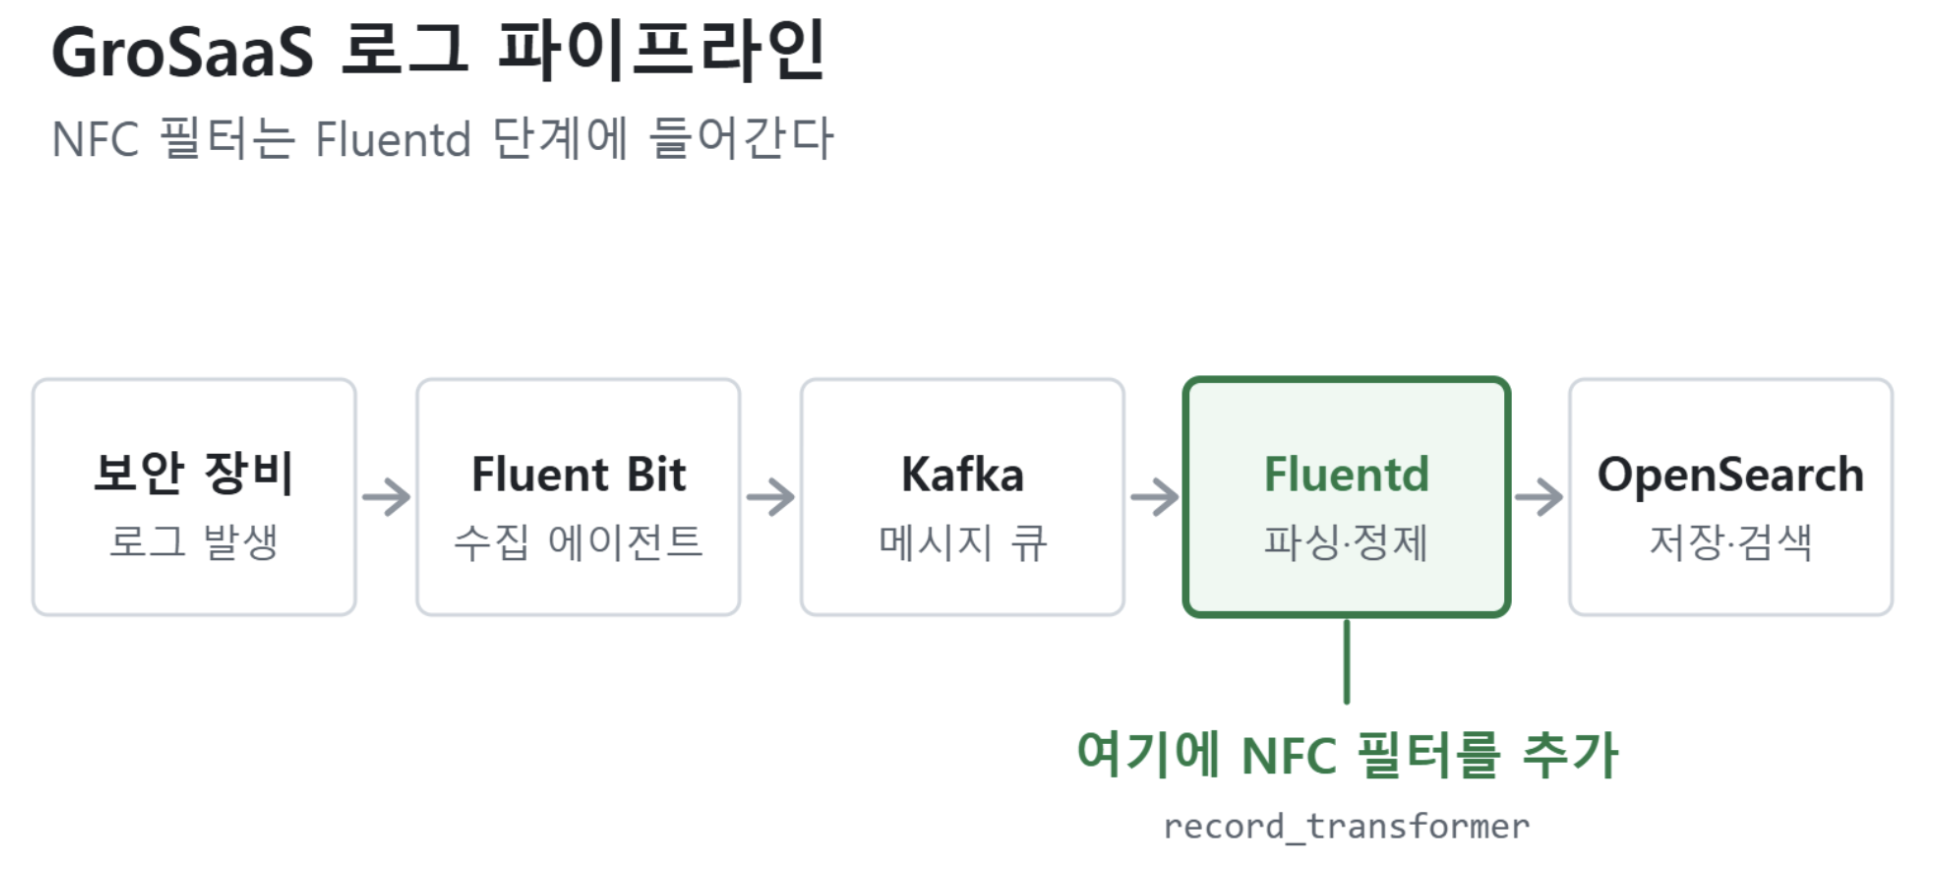
Fluent Bit은 장비 가까이에서 로그를 가볍게 모아 Kafka로 넘깁니다. Fluentd는 Kafka 토픽을 구독(kafka_group 플러그인)해 로그를 꺼내고, 파싱한 뒤 필요한 필드를 정리해서 OpenSearch에 저장합니다. 무거운 가공은 중앙의 Fluentd가 맡고 장비 쪽 에이전트는 가볍게 유지하는 구조입니다. 이번에 만든 NFC 필터도 운영 파이프라인에서는 이 Fluentd 단계에 들어갑니다. 이번 글은 필터만 따로 떼어 검증한 과정입니다.
이벤트: 태그, 시간, 레코드
Fluentd 안에서 로그 한 줄은 이벤트 하나가 되고, 이벤트는 세 부분으로 이루어집니다.
- 태그(tag): 이벤트의 출처를 나타내는 점(.) 구분 문자열(예: waf.raw). 설정 파일이 이 태그를 보고 이벤트를 보낼 필터와 출력을 정함
- 시간(time): 이벤트 발생 시각
- 레코드(record): 실제 내용이 담긴 JSON 형태의 키-값 객체. 파싱 전에는 message 필드 하나에 원본 한 줄이 통째로 들어 있음
설정 파일을 이루는 블록
Fluentd 설정은 지시자(directive) 블록을 쌓아서 만듭니다. 이벤트는 위에서 아래로 내려가며 태그 패턴이 맞는 블록을 차례로 통과합니다.
- <source>: 로그를 받을 위치 지정. tail(파일 읽기), kafka_group(Kafka 구독), forward(다른 Fluentd·Fluent Bit 수신) 등
- <filter 태그패턴>: 이벤트 가공. parser(정규식 등으로 필드 분리), record_transformer(Ruby 식으로 필드 추가·수정), grep(조건에 맞는 이벤트만 선별) 등
- <match 태그패턴>: 이벤트를 보낼 위치 지정. OpenSearch, Kafka, 파일, 표준 출력(stdout) 등
- <parse>, <buffer>: 위 블록 안에 들어가는 하위 블록. <parse>는 원본 문자열의 해석 방식, <buffer>는 출력 전 이벤트를 모아두는 방식
출력 단계의 버퍼는 이벤트를 청크(chunk) 단위로 메모리나 파일에 모았다가 한 번에 보냅니다. 전송에 실패하면 청크를 버퍼에 남겨두고 재시도하므로, OpenSearch가 잠깐 응답하지 않아도 로그가 바로 사라지지 않습니다.
이 블록들은 모두 플러그인으로 구현되어 있습니다. 기본 플러그인 외에 RubyGems로 배포되는 서드파티 플러그인도 많습니다. GroSaaS에서는 공식 컨테이너 이미지(fluent/fluentd:v1.17)에 fluent-plugin-kafka, fluent-plugin-opensearch, fluent-plugin-rewrite-tag-filter를 추가로 설치해 사용합니다.
설계: 작게 떼어낸 독립 필터 ➗
필터를 만들 때 세 가지 약속을 정했습니다.
- 입출력: 원본 글자를 넣으면 UTF-8 + NFC 글자가 나옴
- 실패 처리: UTF-8이 아닌 로그가 들어오면 깨진 채로 흘려보내지 않고 문제 표시(태그)를 남김
- 속도: 필터를 끼운 뒤에도 처리 속도가 눈에 띄게 떨어지지 않음
필터는 파싱 전의 원본 글자 단계에서만 일하는 별도 필터로 분리했습니다. 다른 정리 작업과 섞이지 않아 따로 테스트하기 쉽고, 껐다 켜기도 편합니다. 필터의 처리 순서는 다음과 같습니다.
로그 한 줄 읽기 → 앞부분(시간·보낸 IP) 분리 → 한글 NFC로 통일 → 필드별로 나누기
이 흐름을 Fluentd 설정으로 옮기면 블록 다섯 개가 됩니다. 검증용으로 만든 waf_nfc_only.conf의 구성은 다음과 같습니다.
- 입력(source, tail): WAF 로그 파일을 tail로 읽고 waf.raw 태그 부여. <parse> @type none으로 한 줄 전체를 message 필드에 그대로 저장
- 1단계(filter, parser): 정규식으로 syslog 앞부분의 타임스탬프(syslog_ts)와 보낸 IP(syslog_ip) 분리. 로그 종류(log_type: AUDIT, DETECT, TRAFFIC, SYSTEM)와 나머지 본문(fields_raw)도 함께 분리
- 2단계(filter, record_transformer): 한글이 들어 있는 fields_raw를 NFC로 정규화
- 3단계(filter, parser): |로 구분된 본문에서 위치가 안정적인 앞쪽 필드(waf_id, log_time, mgmt_ip, version)만 이름을 붙이고 나머지는 raw_remainder로 보존
- 출력(match, stdout): 검증 단계이므로 Kafka와 OpenSearch 대신 표준 출력으로 결과 확인
실제 로그 한 줄은 이런 모양입니다(IP는 예시 주소)
2025-07-09T01:43:17.991842+00:00 203.0.113.10 AUDIT|WAF|...
NFC 정규화를 맡는 2단계 필터는 다음과 같습니다.
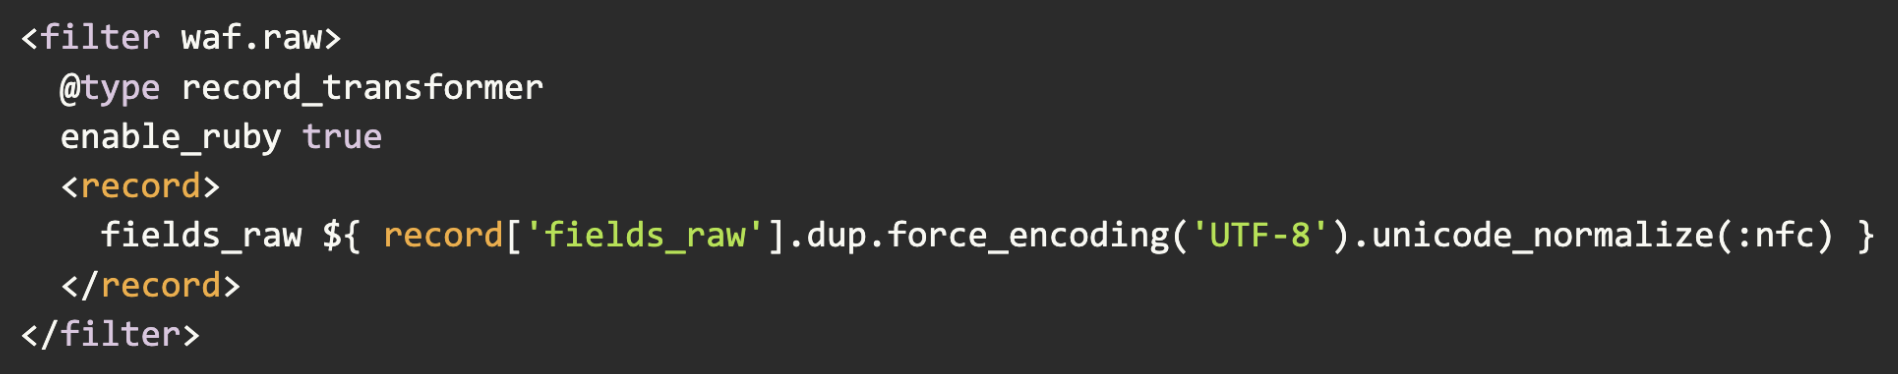
enable_ruby true를 켜면 ${ } 안에 Ruby 식을 쓸 수 있고, record['필드명']으로 현재 이벤트의 값을 읽을 수 있습니다. 정규화는 1단계 뒤, 3단계 앞에 두었습니다. 앞부분의 시간과 IP는 숫자와 영문뿐이라 정규화가 필요 없습니다. 필드를 나눈 뒤에 정규화하면 필드마다 따로 해야 합니다. 한글이 들어 있는 본문 문자열 하나를 한 번만 정규화하는 편이 가장 단순합니다.
트러블슈팅 🙋♀️
ASCII-8BIT 꼬리표로 인한 정규화 오류
한글 정규화 명령은 유니코드 글자에서만 동작합니다. Fluentd가 읽어온 글자에는 이건 그냥 바이너리(ASCII-8BIT)라는 꼬리표가 붙습니다. 내용물은 한글인데 상자 겉면에 엉뚱한 라벨이 붙어 있어서 기계가 처리를 거부했습니다.
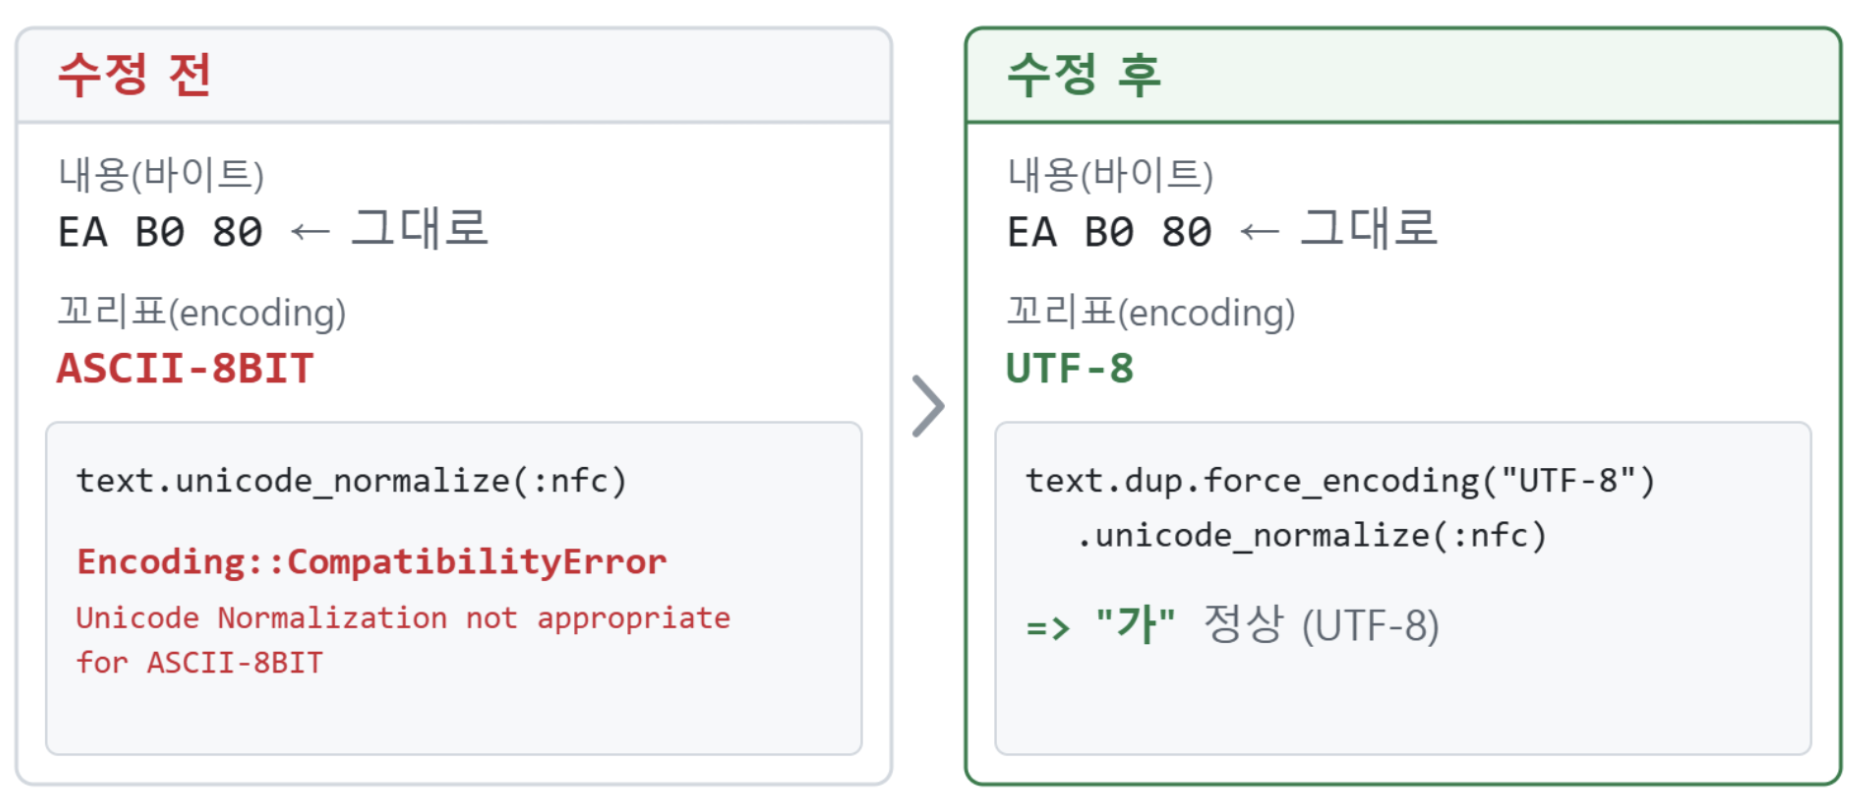
내용은 그대로 두고 꼬리표만 UTF-8로 바로잡은 뒤 정규화하는 방식으로 해결했습니다.

꼬리표를 먼저 고친 뒤 정규화해야 합니다.
ASCII-8BIT 꼬리표는 Fluentd 실행 방식 때문에 붙습니다. Fluentd는 Ruby를 -Eascii-8bit:ascii-8bit 옵션으로 실행하고(실제 실행 로그에서도 확인됩니다), in_tail 플러그인도 encoding 설정이 없으면 읽은 줄을 ASCII-8BIT 문자열로 내보냅니다. 파일에 어떤 인코딩의 글자가 들어 있는지 알 수 없으니 일단 바이트 그대로 넘깁니다. Ruby의 unicode_normalize는 UTF-8 같은 유니코드 인코딩 문자열에서만 동작하므로, 이 상태로 호출하면 Encoding::CompatibilityError가 발생합니다.
in_tail에 encoding 옵션을 주면 읽는 단계에서 꼬리표를 붙일 수도 있습니다. GroSaaS 운영 환경에서는 로그가 Kafka(kafka_group)로 들어오기 때문에, 필터 안에서 직접 꼬리표를 바로잡는 방식을 택했습니다. 이렇게 하면 입력이 파일이든 Kafka든 같은 필터를 그대로 쓸 수 있습니다.
실제 설정에서는 force_encoding 앞에 dup을 붙였습니다. force_encoding은 호출한 문자열 자체의 꼬리표를 바꿉니다. 복사본을 만든 뒤 꼬리표를 바꿔서 원래 레코드의 값을 건드리지 않도록 했습니다.
검증용 설정 미적용
컨테이너가 검증용 설정 대신 운영용 설정으로 실행되었습니다. 검증 대상은 한 번도 적용되지 않았습니다. 이후로는 어떤 설정 파일로 실행 중인지부터 확인하고 시작합니다.
docker-compose.yml에서 fluentd 서비스의 command가 운영용 설정인 realParsingForm.conf로 고정되어 있어서, 컨테이너를 그냥 띄우면 항상 그 설정으로 실행됩니다. 검증용 설정은 command를 덮어써서 따로 실행해야 했습니다.

-c로 설정 파일을 직접 지정하고 -v로 로그 수준을 올리면 확인이 쉬워집니다. Fluentd는 시작할 때 읽어 들인 설정 파일의 경로와 내용을 로그로 출력하므로, 이 부분을 보면 지금 어떤 설정으로 돌고 있는지 바로 알 수 있습니다. 실행 전에 fluentd --dry-run -c <설정 파일>로 문법만 먼저 확인하는 방법도 있습니다.
pos 파일로 인한 재읽기 실패
in_tail은 파일을 어디까지 읽었는지 pos_file에 기록합니다. 덕분에 Fluentd를 재시작해도 이미 보낸 로그를 다시 보내지 않지만, 검증할 때는 이 기능이 걸림돌이 됩니다. 같은 샘플 27줄로 테스트를 반복하려면 매번 pos 파일을 지우고 다시 실행해야 처음부터 읽습니다. read_from_head true 옵션은 pos 파일에 기록이 없을 때만 파일 처음부터 읽게 하므로, pos 파일이 남아 있으면 효과가 없습니다.
검증: 이렇게 확인했습니다 ✅
실제 WAF 로그 샘플 27건으로 두 가지 기준을 확인했습니다.
- 기준 1: 원래 NFC인 글자는 하나도 바뀌지 않음
- 기준 2: NFD로 저장된 글자는 NFC로 변환됨
검증용 스크립트로 자동 확인한 결과, 27건 모두 파싱에 성공했고 한글도 정상으로 나왔습니다.
검증은 두 갈래로 진행했습니다. 하나는 EC2에서 실제 Fluentd를 띄워 stdout에 찍힌 결과를 직접 확인하는 방법이고, 다른 하나는 설정 파일의 1~3단계 로직을 그대로 Python으로 옮긴 스크립트에 같은 샘플을 넣어 보는 방법입니다. 두 결과는 27건 모두 일치했습니다.
기준 1(멱등성)은 필터에 확인용 필드를 하나 더 두어서 확인했습니다. nfc_idempotent 필드에 정규화 전 문자열과 정규화 후 문자열이 같은지를 true/false로 남기도록 했고, 27건 모두 true가 나왔습니다. 기준 2는 실제 샘플이 처음부터 모두 NFC여서 별도로 확인했습니다. 샘플 한 줄을 일부러 NFD로 분해한 합성 로그를 만들어 Python 스크립트로 검증했고, 본문이 109바이트(NFC)에서 166바이트(NFD)로 늘어난 로그를 정규화하자 원본(NFC)과 같은 값이 나왔습니다.
로그 종류별로는 AUDIT 6건, SYSTEM 8건, DETECT 13건이었고, 27건 모두 파싱 오류 없이 필드가 나뉘었습니다.
앞으로 남은 과제, 글을 마치며 ✏️
- 인코딩 오류 표시: UTF-8이 아닌 로그에 문제 표시를 남기는 기능(구현 전)
- 속도 확인: 필터를 끼우기 전후의 처리 속도 비교
- 다른 장비 로그: 이번에는 한 종류의 WAF 로그만 확인했으므로 다른 장비 로그에 같은 필터가 맞는지 점검
- 필드 이름 통일(ECS): 장비마다 다른 필드 이름을 맞추는 작업(다음 단계)
이번 작업으로 WAF 로그의 한글을 NFC 하나로 맞추는 필터를 만들고, 실제 샘플 27건으로 동작을 확인했습니다. 정규화 자체는 Ruby 한 줄(unicode_normalize)로 처리됩니다. 이 한 줄이 제대로 동작하려면 Fluentd가 붙이는 ASCII-8BIT 꼬리표를 먼저 UTF-8로 고치고, 컨테이너가 검증용 설정 파일을 읽고 있는지도 확인해야 합니다.
출처
- Unicode Standard Annex #15, Unicode Normalization Forms: https://unicode.org/reports/tr15/
- Fluentd 공식 문서: https://docs.fluentd.org/
'GroSaaS & Tech' 카테고리의 다른 글
| AI 에이전트 시대의 보안: 몰트북 사태로 본 바이브 코딩의 명과 암 (0) | 2026.03.17 |
|---|